

Upload folder using huggingface_hub
Browse files- .gitattributes +1 -0
- README.md +118 -0
- text_encoder/0.safetensors +3 -0
- text_encoder/1.safetensors +3 -0
- text_encoder/2.safetensors +3 -0
- text_encoder/3.safetensors +3 -0
- text_encoder/4.safetensors +3 -0
- text_encoder/5.safetensors +3 -0
- text_encoder/6.safetensors +3 -0
- text_encoder/model.safetensors.index.json +375 -0
- tokenizer/chat_template.jinja +54 -0
- tokenizer/tokenizer.json +3 -0
- tokenizer/tokenizer_config.json +11 -0
- transformer/0.safetensors +3 -0
- transformer/1.safetensors +3 -0
- transformer/2.safetensors +3 -0
- transformer/3.safetensors +3 -0
- transformer/4.safetensors +3 -0
- transformer/5.safetensors +3 -0
- transformer/6.safetensors +3 -0
- transformer/7.safetensors +3 -0
- transformer/model.safetensors.index.json +0 -0
- vae/0.safetensors +3 -0
- vae/model.safetensors.index.json +200 -0
.gitattributes
CHANGED
|
@@ -33,3 +33,4 @@ saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
|
|
|
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
tokenizer/tokenizer.json filter=lfs diff=lfs merge=lfs -text
|
README.md
ADDED
|
@@ -0,0 +1,118 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
---
|
| 2 |
+
license: apache-2.0
|
| 3 |
+
language:
|
| 4 |
+
- en
|
| 5 |
+
- zh
|
| 6 |
+
base_model:
|
| 7 |
+
- Qwen/Qwen-Image-Layered
|
| 8 |
+
pipeline_tag: image-text-to-image
|
| 9 |
+
library_name: mflux
|
| 10 |
+
tags:
|
| 11 |
+
- mflux
|
| 12 |
+
- apple-silicon
|
| 13 |
+
- mlx
|
| 14 |
+
- quantized
|
| 15 |
+
- image-decomposition
|
| 16 |
+
- rgba
|
| 17 |
+
---
|
| 18 |
+
|
| 19 |
+
# Qwen-Image-Layered (6-bit Quantized for MFLUX)
|
| 20 |
+
|
| 21 |
+
<p align="center">
|
| 22 |
+
<img src="https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-Image/layered/qwen-image-layered-logo.png" width="600"/>
|
| 23 |
+
</p>
|
| 24 |
+
|
| 25 |
+
6-bit quantized version of [Qwen/Qwen-Image-Layered](https://huggingface.co/Qwen/Qwen-Image-Layered) optimized for **Apple Silicon** via [MFLUX](https://github.com/filipstrand/mflux).
|
| 26 |
+
|
| 27 |
+
| Version | Size | VRAM |
|
| 28 |
+
|---------|------|------|
|
| 29 |
+
| BF16 (original) | ~55 GB | ~55 GB |
|
| 30 |
+
| **6-bit (this)** | **~31 GB** | **~29 GB** |
|
| 31 |
+
|
| 32 |
+
## What is Qwen-Image-Layered?
|
| 33 |
+
|
| 34 |
+
Qwen-Image-Layered decomposes any image into multiple **RGBA layers** with transparency. Each layer can be independently edited, moved, resized, or recolored—enabling high-fidelity, consistent image editing.
|
| 35 |
+
|
| 36 |
+
<p align="center">
|
| 37 |
+
<img src="https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-Image/layered/layered.JPG" width="800"/>
|
| 38 |
+
</p>
|
| 39 |
+
|
| 40 |
+
## Quick Start
|
| 41 |
+
|
| 42 |
+
### Installation
|
| 43 |
+
|
| 44 |
+
Requires [MFLUX](https://github.com/filipstrand/mflux) with Qwen-Image-Layered support ([PR #302](https://github.com/filipstrand/mflux/pull/302)):
|
| 45 |
+
|
| 46 |
+
```bash
|
| 47 |
+
# Install from the PR
|
| 48 |
+
git clone https://github.com/zimengxiong/mflux.git
|
| 49 |
+
cd mflux
|
| 50 |
+
uv sync
|
| 51 |
+
```
|
| 52 |
+
|
| 53 |
+
### Usage
|
| 54 |
+
|
| 55 |
+
```bash
|
| 56 |
+
uv run flux-generate-qwen-layered \
|
| 57 |
+
--image input.png \
|
| 58 |
+
--layers 4 \
|
| 59 |
+
--steps 50 \
|
| 60 |
+
-q 6 \
|
| 61 |
+
--output-dir ./layers
|
| 62 |
+
```
|
| 63 |
+
|
| 64 |
+
**Output:** 4 RGBA PNG files (`layer_0.png`, `layer_1.png`, etc.) with transparency.
|
| 65 |
+
|
| 66 |
+
### Parameters
|
| 67 |
+
|
| 68 |
+
| Parameter | Description | Default |
|
| 69 |
+
|-----------|-------------|---------|
|
| 70 |
+
| `--image` | Input image path | Required |
|
| 71 |
+
| `--layers` | Number of layers to decompose | 4 |
|
| 72 |
+
| `--steps` | Inference steps | 50 |
|
| 73 |
+
| `-q` | Quantization (4, 6, or 8-bit) | None (BF16) |
|
| 74 |
+
| `--resolution` | Resolution bucket (640 or 1024) | 640 |
|
| 75 |
+
| `--output-dir` | Output directory for layers | `./` |
|
| 76 |
+
|
| 77 |
+
## Example
|
| 78 |
+
|
| 79 |
+
**Input image:**
|
| 80 |
+
|
| 81 |
+
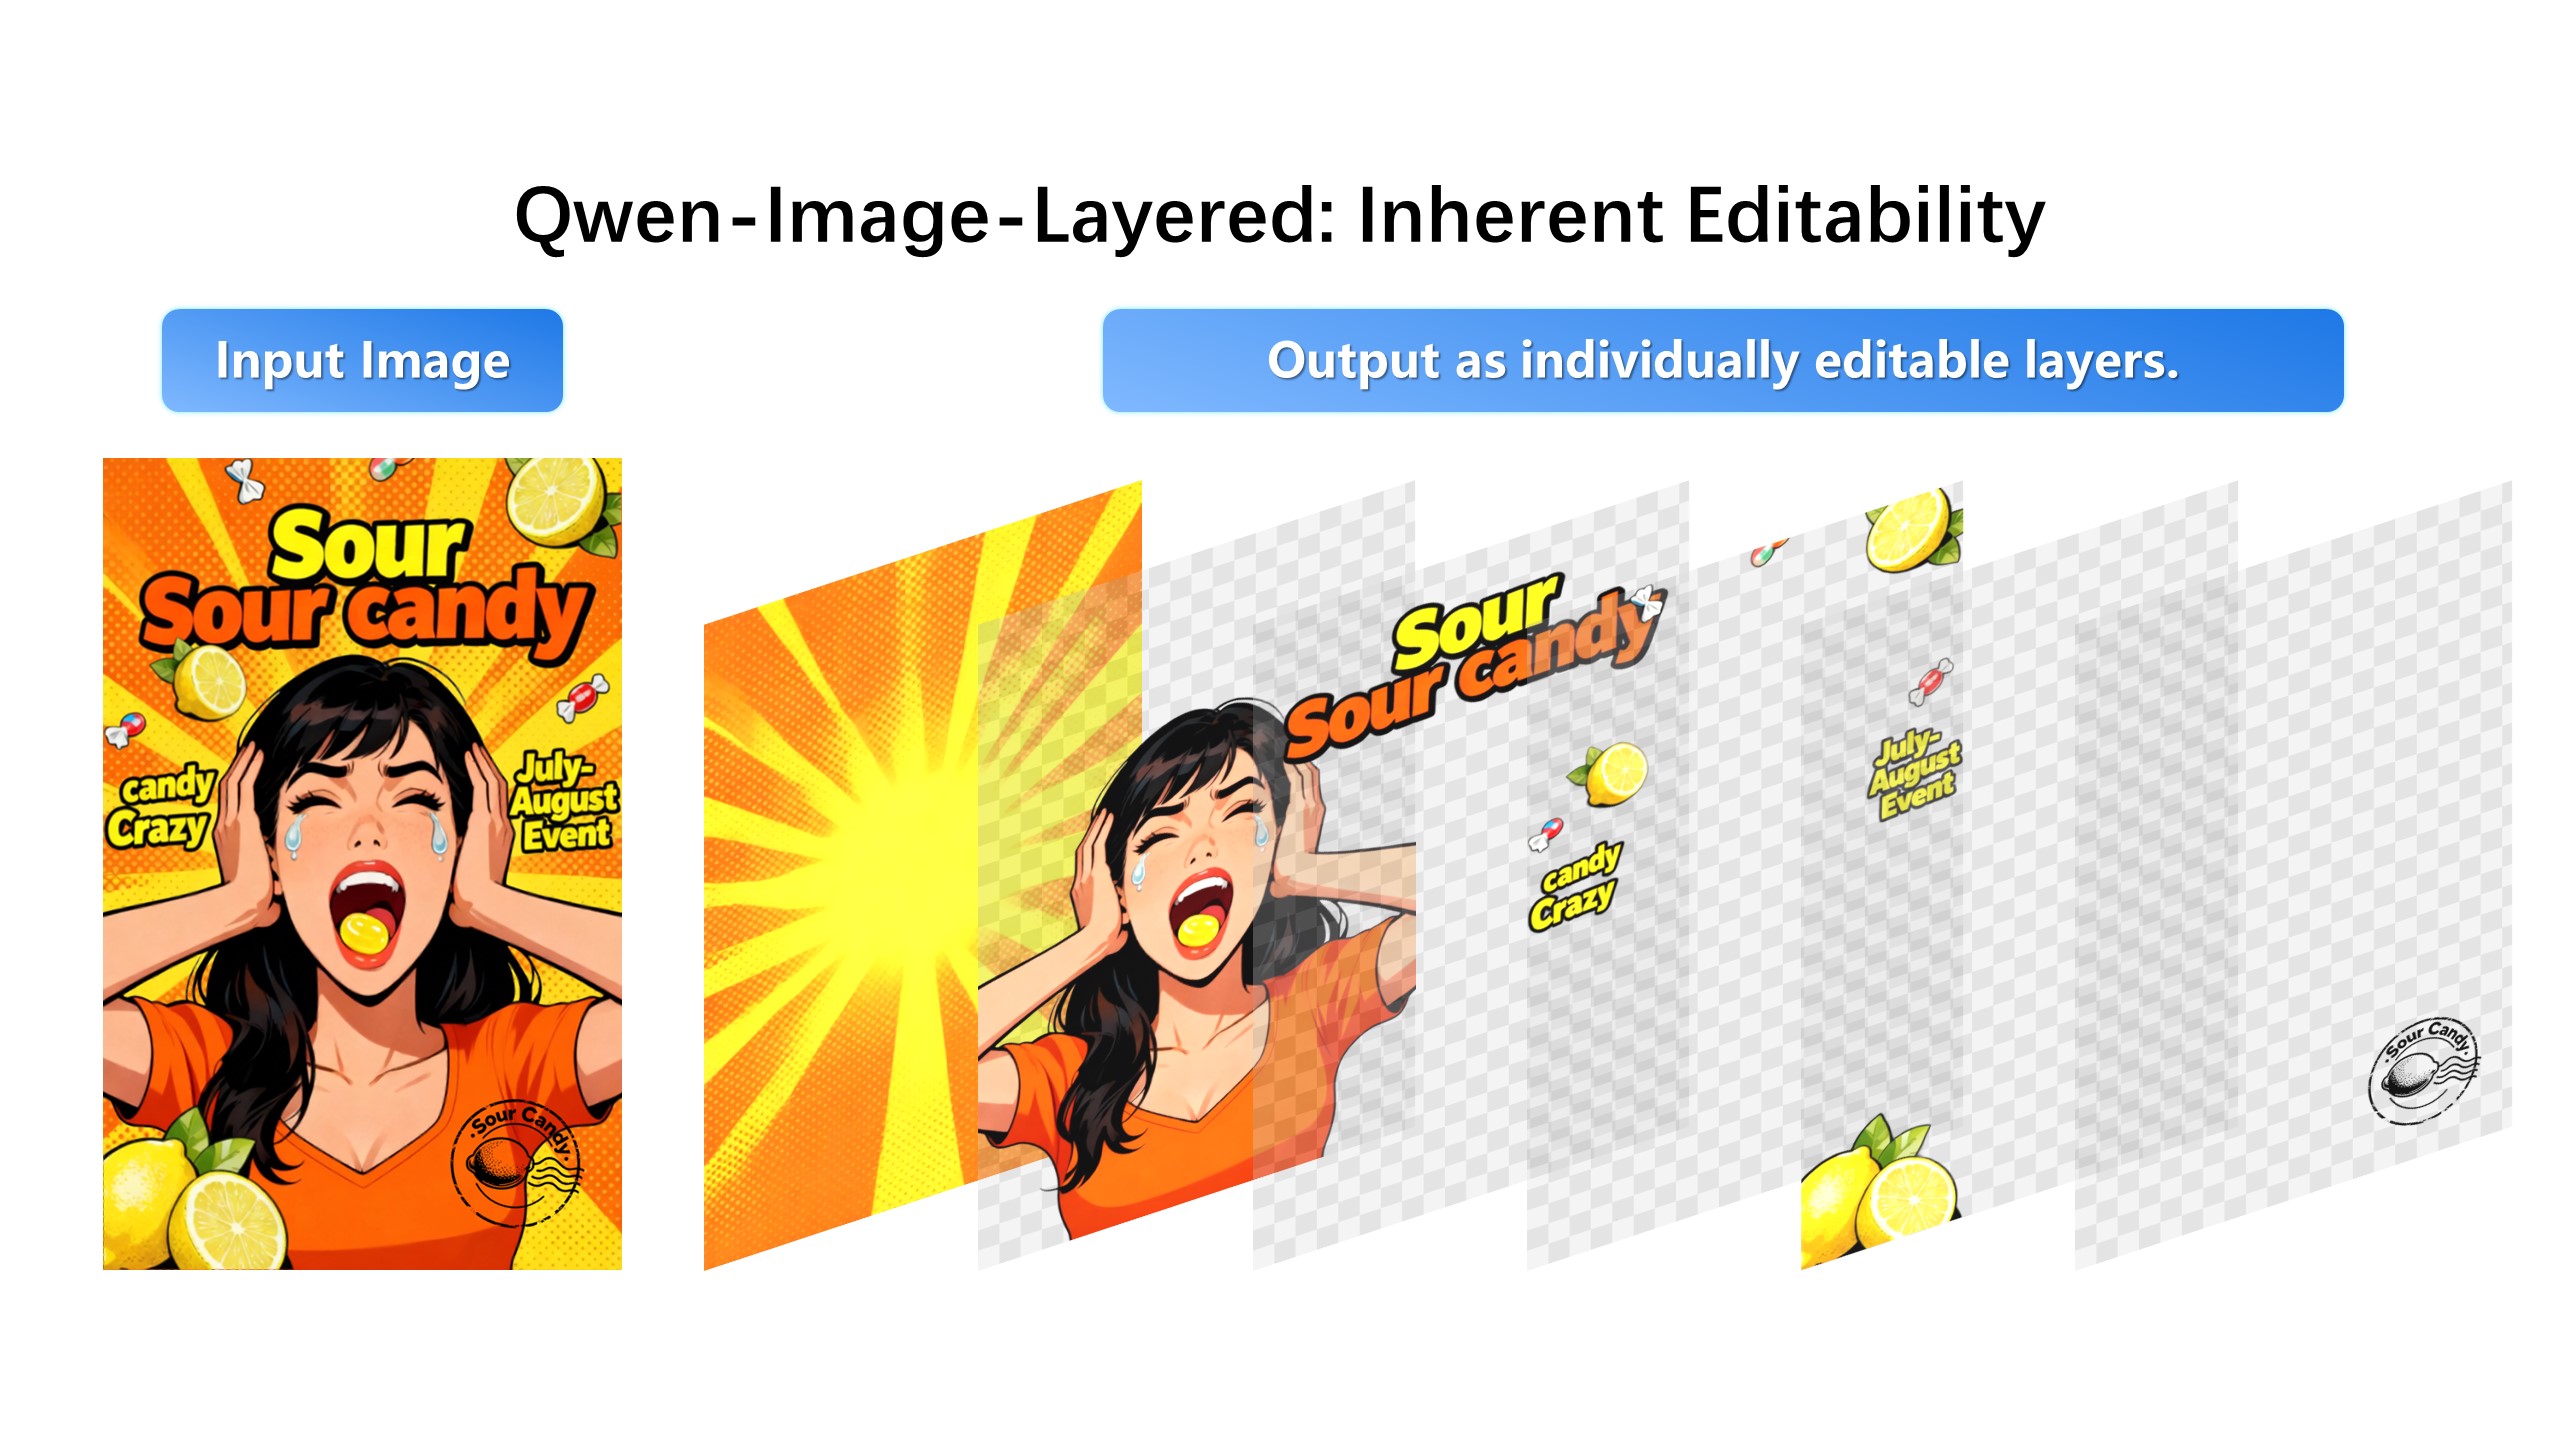
|
| 82 |
+
|
| 83 |
+
## Model Architecture
|
| 84 |
+
|
| 85 |
+
- **Transformer:** QwenImageTransformer2DModel with Layer3D RoPE (3D positional encoding for `[layer, height, width]`)
|
| 86 |
+
- **VAE:** AutoencoderKLQwenImage (RGBA 4-channel with 3D temporal convolutions)
|
| 87 |
+
- **Text Encoder:** Qwen2.5-VL for conditioning
|
| 88 |
+
|
| 89 |
+
## Hardware Requirements
|
| 90 |
+
|
| 91 |
+
- **Apple Silicon Mac** (M1/M2/M3/M4 series)
|
| 92 |
+
- **Minimum 24GB unified memory** (32GB+ recommended)
|
| 93 |
+
- macOS 13.0+
|
| 94 |
+
|
| 95 |
+
## Links
|
| 96 |
+
|
| 97 |
+
- 📦 [MFLUX](https://github.com/filipstrand/mflux) - Fast MLX inference for Apple Silicon
|
| 98 |
+
- 🤗 [Original Model](https://huggingface.co/Qwen/Qwen-Image-Layered) - Full BF16 weights
|
| 99 |
+
- 📑 [Paper](https://arxiv.org/abs/2512.15603) - Research paper
|
| 100 |
+
- 📑 [Blog](https://qwenlm.github.io/blog/qwen-image-layered/) - Official blog post
|
| 101 |
+
|
| 102 |
+
## License
|
| 103 |
+
|
| 104 |
+
Apache 2.0 (same as original model)
|
| 105 |
+
|
| 106 |
+
## Citation
|
| 107 |
+
|
| 108 |
+
```bibtex
|
| 109 |
+
@misc{yin2025qwenimagelayered,
|
| 110 |
+
title={Qwen-Image-Layered: Towards Inherent Editability via Layer Decomposition},
|
| 111 |
+
author={Shengming Yin, Zekai Zhang, Zecheng Tang, Kaiyuan Gao, Xiao Xu, Kun Yan, Jiahao Li, Yilei Chen, Yuxiang Chen, Heung-Yeung Shum, Lionel M. Ni, Jingren Zhou, Junyang Lin, Chenfei Wu},
|
| 112 |
+
year={2025},
|
| 113 |
+
eprint={2512.15603},
|
| 114 |
+
archivePrefix={arXiv},
|
| 115 |
+
primaryClass={cs.CV},
|
| 116 |
+
url={https://arxiv.org/abs/2512.15603},
|
| 117 |
+
}
|
| 118 |
+
```
|
text_encoder/0.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:5057d57ba51ccbe16b6cb72c2c50fa60790d557cbfce68d3a46fd31ad506a5ec
|
| 3 |
+
size 2080974775
|
text_encoder/1.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:25487b7ac743a1352ec19468fd8bca5887453ceb007b4e9a8f9560a81f229375
|
| 3 |
+
size 2136050841
|
text_encoder/2.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:e7a76ccb09e833bb67bcd2a5bdd6b48d6b61f238fe2ae2d8e4e98b477cbf6956
|
| 3 |
+
size 2059005337
|
text_encoder/3.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:9bc59df07bc51cdcfd531128c0a4b806722af27bfac022561f8dfdf0d193d519
|
| 3 |
+
size 2136050889
|
text_encoder/4.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:fc4a07b54f3347290cca0a3fc0ffa9f13d5098591b64a34136905ac1d3a35d4e
|
| 3 |
+
size 2059005367
|
text_encoder/5.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:127fa46f1daf82ae0c24d7ebb1b4b4dd0aef147473283776fd07957d2a366a7c
|
| 3 |
+
size 2136050889
|
text_encoder/6.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:c720f15496d5a400923b5dcf2eab2ed9e04479e999e76ad33be1d26d5901068b
|
| 3 |
+
size 1534150412
|
text_encoder/model.safetensors.index.json
ADDED
|
@@ -0,0 +1,375 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"metadata": {
|
| 3 |
+
"quantization_level": "6",
|
| 4 |
+
"mflux_version": "0.13.3"
|
| 5 |
+
},
|
| 6 |
+
"weight_map": {
|
| 7 |
+
"encoder.embed_tokens.weight": "0.safetensors",
|
| 8 |
+
"encoder.layers.0.input_layernorm.weight": "0.safetensors",
|
| 9 |
+
"encoder.layers.0.self_attn.q_proj.weight": "0.safetensors",
|
| 10 |
+
"encoder.layers.0.self_attn.q_proj.bias": "0.safetensors",
|
| 11 |
+
"encoder.layers.0.self_attn.k_proj.weight": "0.safetensors",
|
| 12 |
+
"encoder.layers.0.self_attn.k_proj.bias": "0.safetensors",
|
| 13 |
+
"encoder.layers.0.self_attn.v_proj.weight": "0.safetensors",
|
| 14 |
+
"encoder.layers.0.self_attn.v_proj.bias": "0.safetensors",
|
| 15 |
+
"encoder.layers.0.self_attn.o_proj.weight": "0.safetensors",
|
| 16 |
+
"encoder.layers.0.self_attn.rotary_emb.inv_freq": "0.safetensors",
|
| 17 |
+
"encoder.layers.0.post_attention_layernorm.weight": "0.safetensors",
|
| 18 |
+
"encoder.layers.0.mlp.gate_proj.weight": "0.safetensors",
|
| 19 |
+
"encoder.layers.0.mlp.up_proj.weight": "0.safetensors",
|
| 20 |
+
"encoder.layers.0.mlp.down_proj.weight": "0.safetensors",
|
| 21 |
+
"encoder.layers.1.input_layernorm.weight": "0.safetensors",
|
| 22 |
+
"encoder.layers.1.self_attn.q_proj.weight": "0.safetensors",
|
| 23 |
+
"encoder.layers.1.self_attn.q_proj.bias": "0.safetensors",
|
| 24 |
+
"encoder.layers.1.self_attn.k_proj.weight": "0.safetensors",
|
| 25 |
+
"encoder.layers.1.self_attn.k_proj.bias": "0.safetensors",
|
| 26 |
+
"encoder.layers.1.self_attn.v_proj.weight": "0.safetensors",
|
| 27 |
+
"encoder.layers.1.self_attn.v_proj.bias": "0.safetensors",
|
| 28 |
+
"encoder.layers.1.self_attn.o_proj.weight": "0.safetensors",
|
| 29 |
+
"encoder.layers.1.self_attn.rotary_emb.inv_freq": "0.safetensors",
|
| 30 |
+
"encoder.layers.1.post_attention_layernorm.weight": "0.safetensors",
|
| 31 |
+
"encoder.layers.1.mlp.gate_proj.weight": "0.safetensors",
|
| 32 |
+
"encoder.layers.1.mlp.up_proj.weight": "0.safetensors",
|
| 33 |
+
"encoder.layers.1.mlp.down_proj.weight": "0.safetensors",
|
| 34 |
+
"encoder.layers.2.input_layernorm.weight": "0.safetensors",
|
| 35 |
+
"encoder.layers.2.self_attn.q_proj.weight": "0.safetensors",
|
| 36 |
+
"encoder.layers.2.self_attn.q_proj.bias": "0.safetensors",
|
| 37 |
+
"encoder.layers.2.self_attn.k_proj.weight": "0.safetensors",
|
| 38 |
+
"encoder.layers.2.self_attn.k_proj.bias": "0.safetensors",
|
| 39 |
+
"encoder.layers.2.self_attn.v_proj.weight": "0.safetensors",
|
| 40 |
+
"encoder.layers.2.self_attn.v_proj.bias": "0.safetensors",
|
| 41 |
+
"encoder.layers.2.self_attn.o_proj.weight": "0.safetensors",
|
| 42 |
+
"encoder.layers.2.self_attn.rotary_emb.inv_freq": "0.safetensors",
|
| 43 |
+
"encoder.layers.2.post_attention_layernorm.weight": "0.safetensors",
|
| 44 |
+
"encoder.layers.2.mlp.gate_proj.weight": "1.safetensors",
|
| 45 |
+
"encoder.layers.2.mlp.up_proj.weight": "1.safetensors",
|
| 46 |
+
"encoder.layers.2.mlp.down_proj.weight": "1.safetensors",
|
| 47 |
+
"encoder.layers.3.input_layernorm.weight": "1.safetensors",
|
| 48 |
+
"encoder.layers.3.self_attn.q_proj.weight": "1.safetensors",
|
| 49 |
+
"encoder.layers.3.self_attn.q_proj.bias": "1.safetensors",
|
| 50 |
+
"encoder.layers.3.self_attn.k_proj.weight": "1.safetensors",
|
| 51 |
+
"encoder.layers.3.self_attn.k_proj.bias": "1.safetensors",
|
| 52 |
+
"encoder.layers.3.self_attn.v_proj.weight": "1.safetensors",
|
| 53 |
+
"encoder.layers.3.self_attn.v_proj.bias": "1.safetensors",
|
| 54 |
+
"encoder.layers.3.self_attn.o_proj.weight": "1.safetensors",
|
| 55 |
+
"encoder.layers.3.self_attn.rotary_emb.inv_freq": "1.safetensors",
|
| 56 |
+
"encoder.layers.3.post_attention_layernorm.weight": "1.safetensors",
|
| 57 |
+
"encoder.layers.3.mlp.gate_proj.weight": "1.safetensors",
|
| 58 |
+
"encoder.layers.3.mlp.up_proj.weight": "1.safetensors",
|
| 59 |
+
"encoder.layers.3.mlp.down_proj.weight": "1.safetensors",
|
| 60 |
+
"encoder.layers.4.input_layernorm.weight": "1.safetensors",
|
| 61 |
+
"encoder.layers.4.self_attn.q_proj.weight": "1.safetensors",
|
| 62 |
+
"encoder.layers.4.self_attn.q_proj.bias": "1.safetensors",
|
| 63 |
+
"encoder.layers.4.self_attn.k_proj.weight": "1.safetensors",
|
| 64 |
+
"encoder.layers.4.self_attn.k_proj.bias": "1.safetensors",
|
| 65 |
+
"encoder.layers.4.self_attn.v_proj.weight": "1.safetensors",
|
| 66 |
+
"encoder.layers.4.self_attn.v_proj.bias": "1.safetensors",
|
| 67 |
+
"encoder.layers.4.self_attn.o_proj.weight": "1.safetensors",
|
| 68 |
+
"encoder.layers.4.self_attn.rotary_emb.inv_freq": "1.safetensors",
|
| 69 |
+
"encoder.layers.4.post_attention_layernorm.weight": "1.safetensors",
|
| 70 |
+
"encoder.layers.4.mlp.gate_proj.weight": "1.safetensors",
|
| 71 |
+
"encoder.layers.4.mlp.up_proj.weight": "1.safetensors",
|
| 72 |
+
"encoder.layers.4.mlp.down_proj.weight": "1.safetensors",
|
| 73 |
+
"encoder.layers.5.input_layernorm.weight": "1.safetensors",
|
| 74 |
+
"encoder.layers.5.self_attn.q_proj.weight": "1.safetensors",
|
| 75 |
+
"encoder.layers.5.self_attn.q_proj.bias": "1.safetensors",
|
| 76 |
+
"encoder.layers.5.self_attn.k_proj.weight": "1.safetensors",
|
| 77 |
+
"encoder.layers.5.self_attn.k_proj.bias": "1.safetensors",
|
| 78 |
+
"encoder.layers.5.self_attn.v_proj.weight": "1.safetensors",
|
| 79 |
+
"encoder.layers.5.self_attn.v_proj.bias": "1.safetensors",
|
| 80 |
+
"encoder.layers.5.self_attn.o_proj.weight": "1.safetensors",
|
| 81 |
+
"encoder.layers.5.self_attn.rotary_emb.inv_freq": "1.safetensors",
|
| 82 |
+
"encoder.layers.5.post_attention_layernorm.weight": "1.safetensors",
|
| 83 |
+
"encoder.layers.5.mlp.gate_proj.weight": "1.safetensors",
|
| 84 |
+
"encoder.layers.5.mlp.up_proj.weight": "1.safetensors",
|
| 85 |
+
"encoder.layers.5.mlp.down_proj.weight": "1.safetensors",
|
| 86 |
+
"encoder.layers.6.input_layernorm.weight": "1.safetensors",
|
| 87 |
+
"encoder.layers.6.self_attn.q_proj.weight": "1.safetensors",
|
| 88 |
+
"encoder.layers.6.self_attn.q_proj.bias": "1.safetensors",
|
| 89 |
+
"encoder.layers.6.self_attn.k_proj.weight": "1.safetensors",
|
| 90 |
+
"encoder.layers.6.self_attn.k_proj.bias": "1.safetensors",
|
| 91 |
+
"encoder.layers.6.self_attn.v_proj.weight": "1.safetensors",
|
| 92 |
+
"encoder.layers.6.self_attn.v_proj.bias": "1.safetensors",
|
| 93 |
+
"encoder.layers.6.self_attn.o_proj.weight": "1.safetensors",
|
| 94 |
+
"encoder.layers.6.self_attn.rotary_emb.inv_freq": "1.safetensors",
|
| 95 |
+
"encoder.layers.6.post_attention_layernorm.weight": "1.safetensors",
|
| 96 |
+
"encoder.layers.6.mlp.gate_proj.weight": "1.safetensors",
|
| 97 |
+
"encoder.layers.6.mlp.up_proj.weight": "1.safetensors",
|
| 98 |
+
"encoder.layers.6.mlp.down_proj.weight": "2.safetensors",
|
| 99 |
+
"encoder.layers.7.input_layernorm.weight": "2.safetensors",
|
| 100 |
+
"encoder.layers.7.self_attn.q_proj.weight": "2.safetensors",
|
| 101 |
+
"encoder.layers.7.self_attn.q_proj.bias": "2.safetensors",
|
| 102 |
+
"encoder.layers.7.self_attn.k_proj.weight": "2.safetensors",
|
| 103 |
+
"encoder.layers.7.self_attn.k_proj.bias": "2.safetensors",
|
| 104 |
+
"encoder.layers.7.self_attn.v_proj.weight": "2.safetensors",
|
| 105 |
+
"encoder.layers.7.self_attn.v_proj.bias": "2.safetensors",
|
| 106 |
+
"encoder.layers.7.self_attn.o_proj.weight": "2.safetensors",
|
| 107 |
+
"encoder.layers.7.self_attn.rotary_emb.inv_freq": "2.safetensors",
|
| 108 |
+
"encoder.layers.7.post_attention_layernorm.weight": "2.safetensors",
|
| 109 |
+
"encoder.layers.7.mlp.gate_proj.weight": "2.safetensors",
|
| 110 |
+
"encoder.layers.7.mlp.up_proj.weight": "2.safetensors",
|
| 111 |
+
"encoder.layers.7.mlp.down_proj.weight": "2.safetensors",
|
| 112 |
+
"encoder.layers.8.input_layernorm.weight": "2.safetensors",
|
| 113 |
+
"encoder.layers.8.self_attn.q_proj.weight": "2.safetensors",
|
| 114 |
+
"encoder.layers.8.self_attn.q_proj.bias": "2.safetensors",
|
| 115 |
+
"encoder.layers.8.self_attn.k_proj.weight": "2.safetensors",
|
| 116 |
+
"encoder.layers.8.self_attn.k_proj.bias": "2.safetensors",
|
| 117 |
+
"encoder.layers.8.self_attn.v_proj.weight": "2.safetensors",
|
| 118 |
+
"encoder.layers.8.self_attn.v_proj.bias": "2.safetensors",
|
| 119 |
+
"encoder.layers.8.self_attn.o_proj.weight": "2.safetensors",
|
| 120 |
+
"encoder.layers.8.self_attn.rotary_emb.inv_freq": "2.safetensors",
|
| 121 |
+
"encoder.layers.8.post_attention_layernorm.weight": "2.safetensors",
|
| 122 |
+
"encoder.layers.8.mlp.gate_proj.weight": "2.safetensors",
|
| 123 |
+
"encoder.layers.8.mlp.up_proj.weight": "2.safetensors",
|
| 124 |
+
"encoder.layers.8.mlp.down_proj.weight": "2.safetensors",
|
| 125 |
+
"encoder.layers.9.input_layernorm.weight": "2.safetensors",
|
| 126 |
+
"encoder.layers.9.self_attn.q_proj.weight": "2.safetensors",
|
| 127 |
+
"encoder.layers.9.self_attn.q_proj.bias": "2.safetensors",
|
| 128 |
+
"encoder.layers.9.self_attn.k_proj.weight": "2.safetensors",
|
| 129 |
+
"encoder.layers.9.self_attn.k_proj.bias": "2.safetensors",
|
| 130 |
+
"encoder.layers.9.self_attn.v_proj.weight": "2.safetensors",
|
| 131 |
+
"encoder.layers.9.self_attn.v_proj.bias": "2.safetensors",
|
| 132 |
+
"encoder.layers.9.self_attn.o_proj.weight": "2.safetensors",
|
| 133 |
+
"encoder.layers.9.self_attn.rotary_emb.inv_freq": "2.safetensors",
|
| 134 |
+
"encoder.layers.9.post_attention_layernorm.weight": "2.safetensors",
|
| 135 |
+
"encoder.layers.9.mlp.gate_proj.weight": "2.safetensors",
|
| 136 |
+
"encoder.layers.9.mlp.up_proj.weight": "2.safetensors",
|
| 137 |
+
"encoder.layers.9.mlp.down_proj.weight": "2.safetensors",
|
| 138 |
+
"encoder.layers.10.input_layernorm.weight": "2.safetensors",
|
| 139 |
+
"encoder.layers.10.self_attn.q_proj.weight": "2.safetensors",
|
| 140 |
+
"encoder.layers.10.self_attn.q_proj.bias": "2.safetensors",
|
| 141 |
+
"encoder.layers.10.self_attn.k_proj.weight": "2.safetensors",
|
| 142 |
+
"encoder.layers.10.self_attn.k_proj.bias": "2.safetensors",
|
| 143 |
+
"encoder.layers.10.self_attn.v_proj.weight": "2.safetensors",
|
| 144 |
+
"encoder.layers.10.self_attn.v_proj.bias": "2.safetensors",
|
| 145 |
+
"encoder.layers.10.self_attn.o_proj.weight": "2.safetensors",
|
| 146 |
+
"encoder.layers.10.self_attn.rotary_emb.inv_freq": "2.safetensors",
|
| 147 |
+
"encoder.layers.10.post_attention_layernorm.weight": "2.safetensors",
|
| 148 |
+
"encoder.layers.10.mlp.gate_proj.weight": "2.safetensors",
|
| 149 |
+
"encoder.layers.10.mlp.up_proj.weight": "2.safetensors",
|
| 150 |
+
"encoder.layers.10.mlp.down_proj.weight": "2.safetensors",
|
| 151 |
+
"encoder.layers.11.input_layernorm.weight": "2.safetensors",
|
| 152 |
+
"encoder.layers.11.self_attn.q_proj.weight": "2.safetensors",
|
| 153 |
+
"encoder.layers.11.self_attn.q_proj.bias": "2.safetensors",
|
| 154 |
+
"encoder.layers.11.self_attn.k_proj.weight": "2.safetensors",
|
| 155 |
+
"encoder.layers.11.self_attn.k_proj.bias": "2.safetensors",
|
| 156 |
+
"encoder.layers.11.self_attn.v_proj.weight": "2.safetensors",
|
| 157 |
+
"encoder.layers.11.self_attn.v_proj.bias": "2.safetensors",
|
| 158 |
+
"encoder.layers.11.self_attn.o_proj.weight": "2.safetensors",
|
| 159 |
+
"encoder.layers.11.self_attn.rotary_emb.inv_freq": "2.safetensors",
|
| 160 |
+
"encoder.layers.11.post_attention_layernorm.weight": "2.safetensors",
|
| 161 |
+
"encoder.layers.11.mlp.gate_proj.weight": "3.safetensors",
|
| 162 |
+
"encoder.layers.11.mlp.up_proj.weight": "3.safetensors",
|
| 163 |
+
"encoder.layers.11.mlp.down_proj.weight": "3.safetensors",
|
| 164 |
+
"encoder.layers.12.input_layernorm.weight": "3.safetensors",
|
| 165 |
+
"encoder.layers.12.self_attn.q_proj.weight": "3.safetensors",
|
| 166 |
+
"encoder.layers.12.self_attn.q_proj.bias": "3.safetensors",
|
| 167 |
+
"encoder.layers.12.self_attn.k_proj.weight": "3.safetensors",
|
| 168 |
+
"encoder.layers.12.self_attn.k_proj.bias": "3.safetensors",
|
| 169 |
+
"encoder.layers.12.self_attn.v_proj.weight": "3.safetensors",
|
| 170 |
+
"encoder.layers.12.self_attn.v_proj.bias": "3.safetensors",
|
| 171 |
+
"encoder.layers.12.self_attn.o_proj.weight": "3.safetensors",
|
| 172 |
+
"encoder.layers.12.self_attn.rotary_emb.inv_freq": "3.safetensors",
|
| 173 |
+
"encoder.layers.12.post_attention_layernorm.weight": "3.safetensors",
|
| 174 |
+
"encoder.layers.12.mlp.gate_proj.weight": "3.safetensors",
|
| 175 |
+
"encoder.layers.12.mlp.up_proj.weight": "3.safetensors",
|
| 176 |
+
"encoder.layers.12.mlp.down_proj.weight": "3.safetensors",
|
| 177 |
+
"encoder.layers.13.input_layernorm.weight": "3.safetensors",
|
| 178 |
+
"encoder.layers.13.self_attn.q_proj.weight": "3.safetensors",
|
| 179 |
+
"encoder.layers.13.self_attn.q_proj.bias": "3.safetensors",
|
| 180 |
+
"encoder.layers.13.self_attn.k_proj.weight": "3.safetensors",
|
| 181 |
+
"encoder.layers.13.self_attn.k_proj.bias": "3.safetensors",
|
| 182 |
+
"encoder.layers.13.self_attn.v_proj.weight": "3.safetensors",
|
| 183 |
+
"encoder.layers.13.self_attn.v_proj.bias": "3.safetensors",
|
| 184 |
+
"encoder.layers.13.self_attn.o_proj.weight": "3.safetensors",
|
| 185 |
+
"encoder.layers.13.self_attn.rotary_emb.inv_freq": "3.safetensors",
|
| 186 |
+
"encoder.layers.13.post_attention_layernorm.weight": "3.safetensors",
|
| 187 |
+
"encoder.layers.13.mlp.gate_proj.weight": "3.safetensors",
|
| 188 |
+
"encoder.layers.13.mlp.up_proj.weight": "3.safetensors",
|
| 189 |
+
"encoder.layers.13.mlp.down_proj.weight": "3.safetensors",
|
| 190 |
+
"encoder.layers.14.input_layernorm.weight": "3.safetensors",
|
| 191 |
+
"encoder.layers.14.self_attn.q_proj.weight": "3.safetensors",
|
| 192 |
+
"encoder.layers.14.self_attn.q_proj.bias": "3.safetensors",
|
| 193 |
+
"encoder.layers.14.self_attn.k_proj.weight": "3.safetensors",
|
| 194 |
+
"encoder.layers.14.self_attn.k_proj.bias": "3.safetensors",
|
| 195 |
+
"encoder.layers.14.self_attn.v_proj.weight": "3.safetensors",
|
| 196 |
+
"encoder.layers.14.self_attn.v_proj.bias": "3.safetensors",
|
| 197 |
+
"encoder.layers.14.self_attn.o_proj.weight": "3.safetensors",
|
| 198 |
+
"encoder.layers.14.self_attn.rotary_emb.inv_freq": "3.safetensors",
|
| 199 |
+
"encoder.layers.14.post_attention_layernorm.weight": "3.safetensors",
|
| 200 |
+
"encoder.layers.14.mlp.gate_proj.weight": "3.safetensors",
|
| 201 |
+
"encoder.layers.14.mlp.up_proj.weight": "3.safetensors",
|
| 202 |
+
"encoder.layers.14.mlp.down_proj.weight": "3.safetensors",
|
| 203 |
+
"encoder.layers.15.input_layernorm.weight": "3.safetensors",
|
| 204 |
+
"encoder.layers.15.self_attn.q_proj.weight": "3.safetensors",
|
| 205 |
+
"encoder.layers.15.self_attn.q_proj.bias": "3.safetensors",
|
| 206 |
+
"encoder.layers.15.self_attn.k_proj.weight": "3.safetensors",
|
| 207 |
+
"encoder.layers.15.self_attn.k_proj.bias": "3.safetensors",
|
| 208 |
+
"encoder.layers.15.self_attn.v_proj.weight": "3.safetensors",
|
| 209 |
+
"encoder.layers.15.self_attn.v_proj.bias": "3.safetensors",
|
| 210 |
+
"encoder.layers.15.self_attn.o_proj.weight": "3.safetensors",
|
| 211 |
+
"encoder.layers.15.self_attn.rotary_emb.inv_freq": "3.safetensors",
|
| 212 |
+
"encoder.layers.15.post_attention_layernorm.weight": "3.safetensors",
|
| 213 |
+
"encoder.layers.15.mlp.gate_proj.weight": "3.safetensors",
|
| 214 |
+
"encoder.layers.15.mlp.up_proj.weight": "3.safetensors",
|
| 215 |
+
"encoder.layers.15.mlp.down_proj.weight": "4.safetensors",
|
| 216 |
+
"encoder.layers.16.input_layernorm.weight": "4.safetensors",
|
| 217 |
+
"encoder.layers.16.self_attn.q_proj.weight": "4.safetensors",
|
| 218 |
+
"encoder.layers.16.self_attn.q_proj.bias": "4.safetensors",
|
| 219 |
+
"encoder.layers.16.self_attn.k_proj.weight": "4.safetensors",
|
| 220 |
+
"encoder.layers.16.self_attn.k_proj.bias": "4.safetensors",
|
| 221 |
+
"encoder.layers.16.self_attn.v_proj.weight": "4.safetensors",
|
| 222 |
+
"encoder.layers.16.self_attn.v_proj.bias": "4.safetensors",
|
| 223 |
+
"encoder.layers.16.self_attn.o_proj.weight": "4.safetensors",
|
| 224 |
+
"encoder.layers.16.self_attn.rotary_emb.inv_freq": "4.safetensors",
|
| 225 |
+
"encoder.layers.16.post_attention_layernorm.weight": "4.safetensors",
|
| 226 |
+
"encoder.layers.16.mlp.gate_proj.weight": "4.safetensors",
|
| 227 |
+
"encoder.layers.16.mlp.up_proj.weight": "4.safetensors",
|
| 228 |
+
"encoder.layers.16.mlp.down_proj.weight": "4.safetensors",
|
| 229 |
+
"encoder.layers.17.input_layernorm.weight": "4.safetensors",
|
| 230 |
+
"encoder.layers.17.self_attn.q_proj.weight": "4.safetensors",
|
| 231 |
+
"encoder.layers.17.self_attn.q_proj.bias": "4.safetensors",
|
| 232 |
+
"encoder.layers.17.self_attn.k_proj.weight": "4.safetensors",
|
| 233 |
+
"encoder.layers.17.self_attn.k_proj.bias": "4.safetensors",
|
| 234 |
+
"encoder.layers.17.self_attn.v_proj.weight": "4.safetensors",
|
| 235 |
+
"encoder.layers.17.self_attn.v_proj.bias": "4.safetensors",
|
| 236 |
+
"encoder.layers.17.self_attn.o_proj.weight": "4.safetensors",
|
| 237 |
+
"encoder.layers.17.self_attn.rotary_emb.inv_freq": "4.safetensors",
|
| 238 |
+
"encoder.layers.17.post_attention_layernorm.weight": "4.safetensors",
|
| 239 |
+
"encoder.layers.17.mlp.gate_proj.weight": "4.safetensors",
|
| 240 |
+
"encoder.layers.17.mlp.up_proj.weight": "4.safetensors",
|
| 241 |
+
"encoder.layers.17.mlp.down_proj.weight": "4.safetensors",
|
| 242 |
+
"encoder.layers.18.input_layernorm.weight": "4.safetensors",
|
| 243 |
+
"encoder.layers.18.self_attn.q_proj.weight": "4.safetensors",
|
| 244 |
+
"encoder.layers.18.self_attn.q_proj.bias": "4.safetensors",
|
| 245 |
+
"encoder.layers.18.self_attn.k_proj.weight": "4.safetensors",
|
| 246 |
+
"encoder.layers.18.self_attn.k_proj.bias": "4.safetensors",
|
| 247 |
+
"encoder.layers.18.self_attn.v_proj.weight": "4.safetensors",
|
| 248 |
+
"encoder.layers.18.self_attn.v_proj.bias": "4.safetensors",
|
| 249 |
+
"encoder.layers.18.self_attn.o_proj.weight": "4.safetensors",
|
| 250 |
+
"encoder.layers.18.self_attn.rotary_emb.inv_freq": "4.safetensors",
|
| 251 |
+
"encoder.layers.18.post_attention_layernorm.weight": "4.safetensors",
|
| 252 |
+
"encoder.layers.18.mlp.gate_proj.weight": "4.safetensors",
|
| 253 |
+
"encoder.layers.18.mlp.up_proj.weight": "4.safetensors",
|
| 254 |
+
"encoder.layers.18.mlp.down_proj.weight": "4.safetensors",
|
| 255 |
+
"encoder.layers.19.input_layernorm.weight": "4.safetensors",
|
| 256 |
+
"encoder.layers.19.self_attn.q_proj.weight": "4.safetensors",
|
| 257 |
+
"encoder.layers.19.self_attn.q_proj.bias": "4.safetensors",
|
| 258 |
+
"encoder.layers.19.self_attn.k_proj.weight": "4.safetensors",
|
| 259 |
+
"encoder.layers.19.self_attn.k_proj.bias": "4.safetensors",
|
| 260 |
+
"encoder.layers.19.self_attn.v_proj.weight": "4.safetensors",
|
| 261 |
+
"encoder.layers.19.self_attn.v_proj.bias": "4.safetensors",
|
| 262 |
+
"encoder.layers.19.self_attn.o_proj.weight": "4.safetensors",
|
| 263 |
+
"encoder.layers.19.self_attn.rotary_emb.inv_freq": "4.safetensors",
|
| 264 |
+
"encoder.layers.19.post_attention_layernorm.weight": "4.safetensors",
|
| 265 |
+
"encoder.layers.19.mlp.gate_proj.weight": "4.safetensors",
|
| 266 |
+
"encoder.layers.19.mlp.up_proj.weight": "4.safetensors",
|
| 267 |
+
"encoder.layers.19.mlp.down_proj.weight": "4.safetensors",
|
| 268 |
+
"encoder.layers.20.input_layernorm.weight": "4.safetensors",
|
| 269 |
+
"encoder.layers.20.self_attn.q_proj.weight": "4.safetensors",
|
| 270 |
+
"encoder.layers.20.self_attn.q_proj.bias": "4.safetensors",
|
| 271 |
+
"encoder.layers.20.self_attn.k_proj.weight": "4.safetensors",
|
| 272 |
+
"encoder.layers.20.self_attn.k_proj.bias": "4.safetensors",
|
| 273 |
+
"encoder.layers.20.self_attn.v_proj.weight": "4.safetensors",
|
| 274 |
+
"encoder.layers.20.self_attn.v_proj.bias": "4.safetensors",
|
| 275 |
+
"encoder.layers.20.self_attn.o_proj.weight": "4.safetensors",
|
| 276 |
+
"encoder.layers.20.self_attn.rotary_emb.inv_freq": "4.safetensors",
|
| 277 |
+
"encoder.layers.20.post_attention_layernorm.weight": "4.safetensors",
|
| 278 |
+
"encoder.layers.20.mlp.gate_proj.weight": "5.safetensors",
|
| 279 |
+
"encoder.layers.20.mlp.up_proj.weight": "5.safetensors",
|
| 280 |
+
"encoder.layers.20.mlp.down_proj.weight": "5.safetensors",
|
| 281 |
+
"encoder.layers.21.input_layernorm.weight": "5.safetensors",
|
| 282 |
+
"encoder.layers.21.self_attn.q_proj.weight": "5.safetensors",
|
| 283 |
+
"encoder.layers.21.self_attn.q_proj.bias": "5.safetensors",
|
| 284 |
+
"encoder.layers.21.self_attn.k_proj.weight": "5.safetensors",
|
| 285 |
+
"encoder.layers.21.self_attn.k_proj.bias": "5.safetensors",
|
| 286 |
+
"encoder.layers.21.self_attn.v_proj.weight": "5.safetensors",
|
| 287 |
+
"encoder.layers.21.self_attn.v_proj.bias": "5.safetensors",
|
| 288 |
+
"encoder.layers.21.self_attn.o_proj.weight": "5.safetensors",
|
| 289 |
+
"encoder.layers.21.self_attn.rotary_emb.inv_freq": "5.safetensors",
|
| 290 |
+
"encoder.layers.21.post_attention_layernorm.weight": "5.safetensors",
|
| 291 |
+
"encoder.layers.21.mlp.gate_proj.weight": "5.safetensors",
|
| 292 |
+
"encoder.layers.21.mlp.up_proj.weight": "5.safetensors",
|
| 293 |
+
"encoder.layers.21.mlp.down_proj.weight": "5.safetensors",
|
| 294 |
+
"encoder.layers.22.input_layernorm.weight": "5.safetensors",
|
| 295 |
+
"encoder.layers.22.self_attn.q_proj.weight": "5.safetensors",
|
| 296 |
+
"encoder.layers.22.self_attn.q_proj.bias": "5.safetensors",
|
| 297 |
+
"encoder.layers.22.self_attn.k_proj.weight": "5.safetensors",
|
| 298 |
+
"encoder.layers.22.self_attn.k_proj.bias": "5.safetensors",
|
| 299 |
+
"encoder.layers.22.self_attn.v_proj.weight": "5.safetensors",
|
| 300 |
+
"encoder.layers.22.self_attn.v_proj.bias": "5.safetensors",
|
| 301 |
+
"encoder.layers.22.self_attn.o_proj.weight": "5.safetensors",
|
| 302 |
+
"encoder.layers.22.self_attn.rotary_emb.inv_freq": "5.safetensors",
|
| 303 |
+
"encoder.layers.22.post_attention_layernorm.weight": "5.safetensors",
|
| 304 |
+
"encoder.layers.22.mlp.gate_proj.weight": "5.safetensors",
|
| 305 |
+
"encoder.layers.22.mlp.up_proj.weight": "5.safetensors",
|
| 306 |
+
"encoder.layers.22.mlp.down_proj.weight": "5.safetensors",
|
| 307 |
+
"encoder.layers.23.input_layernorm.weight": "5.safetensors",
|
| 308 |
+
"encoder.layers.23.self_attn.q_proj.weight": "5.safetensors",
|
| 309 |
+
"encoder.layers.23.self_attn.q_proj.bias": "5.safetensors",
|
| 310 |
+
"encoder.layers.23.self_attn.k_proj.weight": "5.safetensors",
|
| 311 |
+
"encoder.layers.23.self_attn.k_proj.bias": "5.safetensors",
|
| 312 |
+
"encoder.layers.23.self_attn.v_proj.weight": "5.safetensors",
|
| 313 |
+
"encoder.layers.23.self_attn.v_proj.bias": "5.safetensors",
|
| 314 |
+
"encoder.layers.23.self_attn.o_proj.weight": "5.safetensors",
|
| 315 |
+
"encoder.layers.23.self_attn.rotary_emb.inv_freq": "5.safetensors",
|
| 316 |
+
"encoder.layers.23.post_attention_layernorm.weight": "5.safetensors",
|
| 317 |
+
"encoder.layers.23.mlp.gate_proj.weight": "5.safetensors",
|
| 318 |
+
"encoder.layers.23.mlp.up_proj.weight": "5.safetensors",
|
| 319 |
+
"encoder.layers.23.mlp.down_proj.weight": "5.safetensors",
|
| 320 |
+
"encoder.layers.24.input_layernorm.weight": "5.safetensors",
|
| 321 |
+
"encoder.layers.24.self_attn.q_proj.weight": "5.safetensors",
|
| 322 |
+
"encoder.layers.24.self_attn.q_proj.bias": "5.safetensors",
|
| 323 |
+
"encoder.layers.24.self_attn.k_proj.weight": "5.safetensors",
|
| 324 |
+
"encoder.layers.24.self_attn.k_proj.bias": "5.safetensors",
|
| 325 |
+
"encoder.layers.24.self_attn.v_proj.weight": "5.safetensors",
|
| 326 |
+
"encoder.layers.24.self_attn.v_proj.bias": "5.safetensors",
|
| 327 |
+
"encoder.layers.24.self_attn.o_proj.weight": "5.safetensors",
|
| 328 |
+
"encoder.layers.24.self_attn.rotary_emb.inv_freq": "5.safetensors",
|
| 329 |
+
"encoder.layers.24.post_attention_layernorm.weight": "5.safetensors",
|
| 330 |
+
"encoder.layers.24.mlp.gate_proj.weight": "5.safetensors",
|
| 331 |
+
"encoder.layers.24.mlp.up_proj.weight": "5.safetensors",
|
| 332 |
+
"encoder.layers.24.mlp.down_proj.weight": "6.safetensors",
|
| 333 |
+
"encoder.layers.25.input_layernorm.weight": "6.safetensors",
|
| 334 |
+
"encoder.layers.25.self_attn.q_proj.weight": "6.safetensors",
|
| 335 |
+
"encoder.layers.25.self_attn.q_proj.bias": "6.safetensors",
|
| 336 |
+
"encoder.layers.25.self_attn.k_proj.weight": "6.safetensors",
|
| 337 |
+
"encoder.layers.25.self_attn.k_proj.bias": "6.safetensors",
|
| 338 |
+
"encoder.layers.25.self_attn.v_proj.weight": "6.safetensors",
|
| 339 |
+
"encoder.layers.25.self_attn.v_proj.bias": "6.safetensors",
|
| 340 |
+
"encoder.layers.25.self_attn.o_proj.weight": "6.safetensors",
|
| 341 |
+
"encoder.layers.25.self_attn.rotary_emb.inv_freq": "6.safetensors",
|
| 342 |
+
"encoder.layers.25.post_attention_layernorm.weight": "6.safetensors",
|
| 343 |
+
"encoder.layers.25.mlp.gate_proj.weight": "6.safetensors",
|
| 344 |
+
"encoder.layers.25.mlp.up_proj.weight": "6.safetensors",
|
| 345 |
+
"encoder.layers.25.mlp.down_proj.weight": "6.safetensors",
|
| 346 |
+
"encoder.layers.26.input_layernorm.weight": "6.safetensors",
|
| 347 |
+
"encoder.layers.26.self_attn.q_proj.weight": "6.safetensors",
|
| 348 |
+
"encoder.layers.26.self_attn.q_proj.bias": "6.safetensors",
|
| 349 |
+
"encoder.layers.26.self_attn.k_proj.weight": "6.safetensors",
|
| 350 |
+
"encoder.layers.26.self_attn.k_proj.bias": "6.safetensors",
|
| 351 |
+
"encoder.layers.26.self_attn.v_proj.weight": "6.safetensors",
|
| 352 |
+
"encoder.layers.26.self_attn.v_proj.bias": "6.safetensors",
|
| 353 |
+
"encoder.layers.26.self_attn.o_proj.weight": "6.safetensors",
|
| 354 |
+
"encoder.layers.26.self_attn.rotary_emb.inv_freq": "6.safetensors",
|
| 355 |
+
"encoder.layers.26.post_attention_layernorm.weight": "6.safetensors",
|
| 356 |
+
"encoder.layers.26.mlp.gate_proj.weight": "6.safetensors",
|
| 357 |
+
"encoder.layers.26.mlp.up_proj.weight": "6.safetensors",
|
| 358 |
+
"encoder.layers.26.mlp.down_proj.weight": "6.safetensors",
|
| 359 |
+
"encoder.layers.27.input_layernorm.weight": "6.safetensors",
|
| 360 |
+
"encoder.layers.27.self_attn.q_proj.weight": "6.safetensors",
|
| 361 |
+
"encoder.layers.27.self_attn.q_proj.bias": "6.safetensors",
|
| 362 |
+
"encoder.layers.27.self_attn.k_proj.weight": "6.safetensors",
|
| 363 |
+
"encoder.layers.27.self_attn.k_proj.bias": "6.safetensors",
|
| 364 |
+
"encoder.layers.27.self_attn.v_proj.weight": "6.safetensors",
|
| 365 |
+
"encoder.layers.27.self_attn.v_proj.bias": "6.safetensors",
|
| 366 |
+
"encoder.layers.27.self_attn.o_proj.weight": "6.safetensors",
|
| 367 |
+
"encoder.layers.27.self_attn.rotary_emb.inv_freq": "6.safetensors",
|
| 368 |
+
"encoder.layers.27.post_attention_layernorm.weight": "6.safetensors",
|
| 369 |
+
"encoder.layers.27.mlp.gate_proj.weight": "6.safetensors",
|
| 370 |
+
"encoder.layers.27.mlp.up_proj.weight": "6.safetensors",
|
| 371 |
+
"encoder.layers.27.mlp.down_proj.weight": "6.safetensors",
|
| 372 |
+
"encoder.norm.weight": "6.safetensors",
|
| 373 |
+
"encoder.rotary_emb.inv_freq": "6.safetensors"
|
| 374 |
+
}
|
| 375 |
+
}
|
tokenizer/chat_template.jinja
ADDED
|
@@ -0,0 +1,54 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{%- if tools %}
|
| 2 |
+
{{- '<|im_start|>system\n' }}
|
| 3 |
+
{%- if messages[0]['role'] == 'system' %}
|
| 4 |
+
{{- messages[0]['content'] }}
|
| 5 |
+
{%- else %}
|
| 6 |
+
{{- 'You are a helpful assistant.' }}
|
| 7 |
+
{%- endif %}
|
| 8 |
+
{{- "\n\n# Tools\n\nYou may call one or more functions to assist with the user query.\n\nYou are provided with function signatures within <tools></tools> XML tags:\n<tools>" }}
|
| 9 |
+
{%- for tool in tools %}
|
| 10 |
+
{{- "\n" }}
|
| 11 |
+
{{- tool | tojson }}
|
| 12 |
+
{%- endfor %}
|
| 13 |
+
{{- "\n</tools>\n\nFor each function call, return a json object with function name and arguments within <tool_call></tool_call> XML tags:\n<tool_call>\n{\"name\": <function-name>, \"arguments\": <args-json-object>}\n</tool_call><|im_end|>\n" }}
|
| 14 |
+
{%- else %}
|
| 15 |
+
{%- if messages[0]['role'] == 'system' %}
|
| 16 |
+
{{- '<|im_start|>system\n' + messages[0]['content'] + '<|im_end|>\n' }}
|
| 17 |
+
{%- else %}
|
| 18 |
+
{{- '<|im_start|>system\nYou are a helpful assistant.<|im_end|>\n' }}
|
| 19 |
+
{%- endif %}
|
| 20 |
+
{%- endif %}
|
| 21 |
+
{%- for message in messages %}
|
| 22 |
+
{%- if (message.role == "user") or (message.role == "system" and not loop.first) or (message.role == "assistant" and not message.tool_calls) %}
|
| 23 |
+
{{- '<|im_start|>' + message.role + '\n' + message.content + '<|im_end|>' + '\n' }}
|
| 24 |
+
{%- elif message.role == "assistant" %}
|
| 25 |
+
{{- '<|im_start|>' + message.role }}
|
| 26 |
+
{%- if message.content %}
|
| 27 |
+
{{- '\n' + message.content }}
|
| 28 |
+
{%- endif %}
|
| 29 |
+
{%- for tool_call in message.tool_calls %}
|
| 30 |
+
{%- if tool_call.function is defined %}
|
| 31 |
+
{%- set tool_call = tool_call.function %}
|
| 32 |
+
{%- endif %}
|
| 33 |
+
{{- '\n<tool_call>\n{"name": "' }}
|
| 34 |
+
{{- tool_call.name }}
|
| 35 |
+
{{- '", "arguments": ' }}
|
| 36 |
+
{{- tool_call.arguments | tojson }}
|
| 37 |
+
{{- '}\n</tool_call>' }}
|
| 38 |
+
{%- endfor %}
|
| 39 |
+
{{- '<|im_end|>\n' }}
|
| 40 |
+
{%- elif message.role == "tool" %}
|
| 41 |
+
{%- if (loop.index0 == 0) or (messages[loop.index0 - 1].role != "tool") %}
|
| 42 |
+
{{- '<|im_start|>user' }}
|
| 43 |
+
{%- endif %}
|
| 44 |
+
{{- '\n<tool_response>\n' }}
|
| 45 |
+
{{- message.content }}
|
| 46 |
+
{{- '\n</tool_response>' }}
|
| 47 |
+
{%- if loop.last or (messages[loop.index0 + 1].role != "tool") %}
|
| 48 |
+
{{- '<|im_end|>\n' }}
|
| 49 |
+
{%- endif %}
|
| 50 |
+
{%- endif %}
|
| 51 |
+
{%- endfor %}
|
| 52 |
+
{%- if add_generation_prompt %}
|
| 53 |
+
{{- '<|im_start|>assistant\n' }}
|
| 54 |
+
{%- endif %}
|
tokenizer/tokenizer.json
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:67171c886afe270bc6bad965ab305bcba5e2cf3dc82ee3f61233d99faface637
|
| 3 |
+
size 11416617
|
tokenizer/tokenizer_config.json
ADDED
|
@@ -0,0 +1,11 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"add_prefix_space": null,
|
| 3 |
+
"additional_special_tokens": null,
|
| 4 |
+
"backend": "tokenizers",
|
| 5 |
+
"bos_token": null,
|
| 6 |
+
"eos_token": "<|endoftext|>",
|
| 7 |
+
"model_max_length": 1000000000000000019884624838656,
|
| 8 |
+
"pad_token": "<|endoftext|>",
|
| 9 |
+
"tokenizer_class": "Qwen2Tokenizer",
|
| 10 |
+
"unk_token": "<|endoftext|>"
|
| 11 |
+
}
|
transformer/0.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:b012ab4c8ae37dfc61f7e75a9b956d687442786ac587cf4be5bee266d228b0fc
|
| 3 |
+
size 2119868330
|
transformer/1.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:859e1dde43776bf220488091ff7c667570d916945793c0d22130a866da205247
|
| 3 |
+
size 2140792341
|
transformer/2.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:84178307823d64cd8665089c92266f3800d3ee1f3bd62414909f820a8135733c
|
| 3 |
+
size 2110074865
|
transformer/3.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:52a62a2a7d309dd6ff4bc1ff92ddcad0638ff0f756e48eb86db790c8a02b6850
|
| 3 |
+
size 2146660191
|
transformer/4.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:787e22981d7a7df83bd4a385bc4a64fa050d07a16ffcdbc42ba27d8e4813adfc
|
| 3 |
+
size 2134925685
|
transformer/5.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:4b7b17f8fcd1b59fada08a211225606a9e77e76826abfeb8b01c037960040d73
|
| 3 |
+
size 2140771143
|
transformer/6.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:7c3d949a0bb01382de7337f5f9a2588c79ffe7e4a1a2d01703665386de190156
|
| 3 |
+
size 2140773685
|
transformer/7.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:a556ee2a1cdc92d7a37b7a7cd83e9897d1d04d565496fb327e1b14f5aa803f22
|
| 3 |
+
size 1672888373
|
transformer/model.safetensors.index.json
ADDED
|
The diff for this file is too large to render.
See raw diff
|
|
|
vae/0.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:59d4d01d43bba97ad5a22650a81df631e7779b5024e95d1d5d6ef9b90ec9fa0b
|
| 3 |
+
size 253596517
|
vae/model.safetensors.index.json
ADDED
|
@@ -0,0 +1,200 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"metadata": {
|
| 3 |
+
"quantization_level": "6",
|
| 4 |
+
"mflux_version": "0.13.3"
|
| 5 |
+
},
|
| 6 |
+
"weight_map": {
|
| 7 |
+
"decoder.conv_in.conv3d.weight": "0.safetensors",
|
| 8 |
+
"decoder.conv_in.conv3d.bias": "0.safetensors",
|
| 9 |
+
"decoder.mid_block.attentions.0.norm.weight": "0.safetensors",
|
| 10 |
+
"decoder.mid_block.attentions.0.to_qkv.weight": "0.safetensors",
|
| 11 |
+
"decoder.mid_block.attentions.0.to_qkv.bias": "0.safetensors",
|
| 12 |
+
"decoder.mid_block.attentions.0.proj.weight": "0.safetensors",
|
| 13 |
+
"decoder.mid_block.attentions.0.proj.bias": "0.safetensors",
|
| 14 |
+
"decoder.mid_block.resnets.0.norm1.weight": "0.safetensors",
|
| 15 |
+
"decoder.mid_block.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 16 |
+
"decoder.mid_block.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 17 |
+
"decoder.mid_block.resnets.0.norm2.weight": "0.safetensors",
|
| 18 |
+
"decoder.mid_block.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 19 |
+
"decoder.mid_block.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 20 |
+
"decoder.mid_block.resnets.1.norm1.weight": "0.safetensors",
|
| 21 |
+
"decoder.mid_block.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 22 |
+
"decoder.mid_block.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 23 |
+
"decoder.mid_block.resnets.1.norm2.weight": "0.safetensors",
|
| 24 |
+
"decoder.mid_block.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 25 |
+
"decoder.mid_block.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 26 |
+
"decoder.up_block0.resnets.0.norm1.weight": "0.safetensors",
|
| 27 |
+
"decoder.up_block0.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 28 |
+
"decoder.up_block0.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 29 |
+
"decoder.up_block0.resnets.0.norm2.weight": "0.safetensors",
|
| 30 |
+
"decoder.up_block0.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 31 |
+
"decoder.up_block0.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 32 |
+
"decoder.up_block0.resnets.1.norm1.weight": "0.safetensors",
|
| 33 |
+
"decoder.up_block0.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 34 |
+
"decoder.up_block0.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 35 |
+
"decoder.up_block0.resnets.1.norm2.weight": "0.safetensors",
|
| 36 |
+
"decoder.up_block0.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 37 |
+
"decoder.up_block0.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 38 |
+
"decoder.up_block0.resnets.2.norm1.weight": "0.safetensors",
|
| 39 |
+
"decoder.up_block0.resnets.2.conv1.conv3d.weight": "0.safetensors",
|
| 40 |
+
"decoder.up_block0.resnets.2.conv1.conv3d.bias": "0.safetensors",
|
| 41 |
+
"decoder.up_block0.resnets.2.norm2.weight": "0.safetensors",
|
| 42 |
+
"decoder.up_block0.resnets.2.conv2.conv3d.weight": "0.safetensors",
|
| 43 |
+
"decoder.up_block0.resnets.2.conv2.conv3d.bias": "0.safetensors",
|
| 44 |
+
"decoder.up_block0.upsamplers.0.time_conv.conv3d.weight": "0.safetensors",
|
| 45 |
+
"decoder.up_block0.upsamplers.0.time_conv.conv3d.bias": "0.safetensors",
|
| 46 |
+
"decoder.up_block0.upsamplers.0.resample_conv.weight": "0.safetensors",
|
| 47 |
+
"decoder.up_block0.upsamplers.0.resample_conv.bias": "0.safetensors",
|
| 48 |
+
"decoder.up_block1.resnets.0.norm1.weight": "0.safetensors",
|
| 49 |
+
"decoder.up_block1.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 50 |
+
"decoder.up_block1.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 51 |
+
"decoder.up_block1.resnets.0.norm2.weight": "0.safetensors",
|
| 52 |
+
"decoder.up_block1.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 53 |
+
"decoder.up_block1.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 54 |
+
"decoder.up_block1.resnets.0.skip_conv.conv3d.weight": "0.safetensors",
|
| 55 |
+
"decoder.up_block1.resnets.0.skip_conv.conv3d.bias": "0.safetensors",
|
| 56 |
+
"decoder.up_block1.resnets.1.norm1.weight": "0.safetensors",
|
| 57 |
+
"decoder.up_block1.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 58 |
+
"decoder.up_block1.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 59 |
+
"decoder.up_block1.resnets.1.norm2.weight": "0.safetensors",
|
| 60 |
+
"decoder.up_block1.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 61 |
+
"decoder.up_block1.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 62 |
+
"decoder.up_block1.resnets.2.norm1.weight": "0.safetensors",
|
| 63 |
+
"decoder.up_block1.resnets.2.conv1.conv3d.weight": "0.safetensors",
|
| 64 |
+
"decoder.up_block1.resnets.2.conv1.conv3d.bias": "0.safetensors",
|
| 65 |
+
"decoder.up_block1.resnets.2.norm2.weight": "0.safetensors",
|
| 66 |
+
"decoder.up_block1.resnets.2.conv2.conv3d.weight": "0.safetensors",
|
| 67 |
+
"decoder.up_block1.resnets.2.conv2.conv3d.bias": "0.safetensors",
|
| 68 |
+
"decoder.up_block1.upsamplers.0.time_conv.conv3d.weight": "0.safetensors",
|
| 69 |
+
"decoder.up_block1.upsamplers.0.time_conv.conv3d.bias": "0.safetensors",
|
| 70 |
+
"decoder.up_block1.upsamplers.0.resample_conv.weight": "0.safetensors",
|
| 71 |
+
"decoder.up_block1.upsamplers.0.resample_conv.bias": "0.safetensors",
|
| 72 |
+
"decoder.up_block2.resnets.0.norm1.weight": "0.safetensors",
|
| 73 |
+
"decoder.up_block2.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 74 |
+
"decoder.up_block2.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 75 |
+
"decoder.up_block2.resnets.0.norm2.weight": "0.safetensors",
|
| 76 |
+
"decoder.up_block2.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 77 |
+
"decoder.up_block2.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 78 |
+
"decoder.up_block2.resnets.1.norm1.weight": "0.safetensors",
|
| 79 |
+
"decoder.up_block2.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 80 |
+
"decoder.up_block2.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 81 |
+
"decoder.up_block2.resnets.1.norm2.weight": "0.safetensors",
|
| 82 |
+
"decoder.up_block2.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 83 |
+
"decoder.up_block2.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 84 |
+
"decoder.up_block2.resnets.2.norm1.weight": "0.safetensors",
|
| 85 |
+
"decoder.up_block2.resnets.2.conv1.conv3d.weight": "0.safetensors",
|
| 86 |
+
"decoder.up_block2.resnets.2.conv1.conv3d.bias": "0.safetensors",
|
| 87 |
+
"decoder.up_block2.resnets.2.norm2.weight": "0.safetensors",
|
| 88 |
+
"decoder.up_block2.resnets.2.conv2.conv3d.weight": "0.safetensors",
|
| 89 |
+
"decoder.up_block2.resnets.2.conv2.conv3d.bias": "0.safetensors",
|
| 90 |
+
"decoder.up_block2.upsamplers.0.resample_conv.weight": "0.safetensors",
|
| 91 |
+
"decoder.up_block2.upsamplers.0.resample_conv.bias": "0.safetensors",
|
| 92 |
+
"decoder.up_block3.resnets.0.norm1.weight": "0.safetensors",
|
| 93 |
+
"decoder.up_block3.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 94 |
+
"decoder.up_block3.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 95 |
+
"decoder.up_block3.resnets.0.norm2.weight": "0.safetensors",
|
| 96 |
+
"decoder.up_block3.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 97 |
+
"decoder.up_block3.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 98 |
+
"decoder.up_block3.resnets.1.norm1.weight": "0.safetensors",
|
| 99 |
+
"decoder.up_block3.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 100 |
+
"decoder.up_block3.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 101 |
+
"decoder.up_block3.resnets.1.norm2.weight": "0.safetensors",
|
| 102 |
+
"decoder.up_block3.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 103 |
+
"decoder.up_block3.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 104 |
+
"decoder.up_block3.resnets.2.norm1.weight": "0.safetensors",
|
| 105 |
+
"decoder.up_block3.resnets.2.conv1.conv3d.weight": "0.safetensors",
|
| 106 |
+
"decoder.up_block3.resnets.2.conv1.conv3d.bias": "0.safetensors",
|
| 107 |
+
"decoder.up_block3.resnets.2.norm2.weight": "0.safetensors",
|
| 108 |
+
"decoder.up_block3.resnets.2.conv2.conv3d.weight": "0.safetensors",
|
| 109 |
+
"decoder.up_block3.resnets.2.conv2.conv3d.bias": "0.safetensors",
|
| 110 |
+
"decoder.norm_out.weight": "0.safetensors",
|
| 111 |
+
"decoder.conv_out.conv3d.weight": "0.safetensors",
|
| 112 |
+
"decoder.conv_out.conv3d.bias": "0.safetensors",
|
| 113 |
+
"encoder.conv_in.conv3d.weight": "0.safetensors",
|
| 114 |
+
"encoder.conv_in.conv3d.bias": "0.safetensors",
|
| 115 |
+
"encoder.down_blocks.0.resnets.0.norm1.weight": "0.safetensors",
|
| 116 |
+
"encoder.down_blocks.0.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 117 |
+
"encoder.down_blocks.0.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 118 |
+
"encoder.down_blocks.0.resnets.0.norm2.weight": "0.safetensors",
|
| 119 |
+
"encoder.down_blocks.0.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 120 |
+
"encoder.down_blocks.0.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 121 |
+
"encoder.down_blocks.0.resnets.1.norm1.weight": "0.safetensors",
|
| 122 |
+
"encoder.down_blocks.0.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 123 |
+
"encoder.down_blocks.0.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 124 |
+
"encoder.down_blocks.0.resnets.1.norm2.weight": "0.safetensors",
|
| 125 |
+
"encoder.down_blocks.0.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 126 |
+
"encoder.down_blocks.0.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 127 |
+
"encoder.down_blocks.0.downsamplers.0.resample_conv.weight": "0.safetensors",
|
| 128 |
+
"encoder.down_blocks.0.downsamplers.0.resample_conv.bias": "0.safetensors",
|
| 129 |
+
"encoder.down_blocks.1.resnets.0.norm1.weight": "0.safetensors",
|
| 130 |
+
"encoder.down_blocks.1.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 131 |
+
"encoder.down_blocks.1.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 132 |
+
"encoder.down_blocks.1.resnets.0.norm2.weight": "0.safetensors",
|
| 133 |
+
"encoder.down_blocks.1.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 134 |
+
"encoder.down_blocks.1.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 135 |
+
"encoder.down_blocks.1.resnets.0.skip_conv.conv3d.weight": "0.safetensors",
|
| 136 |
+
"encoder.down_blocks.1.resnets.0.skip_conv.conv3d.bias": "0.safetensors",
|
| 137 |
+
"encoder.down_blocks.1.resnets.1.norm1.weight": "0.safetensors",
|
| 138 |
+
"encoder.down_blocks.1.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 139 |
+
"encoder.down_blocks.1.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 140 |
+
"encoder.down_blocks.1.resnets.1.norm2.weight": "0.safetensors",
|
| 141 |
+
"encoder.down_blocks.1.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 142 |
+
"encoder.down_blocks.1.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 143 |
+
"encoder.down_blocks.1.downsamplers.0.resample_conv.weight": "0.safetensors",
|
| 144 |
+
"encoder.down_blocks.1.downsamplers.0.resample_conv.bias": "0.safetensors",
|
| 145 |
+
"encoder.down_blocks.2.resnets.0.norm1.weight": "0.safetensors",
|
| 146 |
+
"encoder.down_blocks.2.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 147 |
+
"encoder.down_blocks.2.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 148 |
+
"encoder.down_blocks.2.resnets.0.norm2.weight": "0.safetensors",
|
| 149 |
+
"encoder.down_blocks.2.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 150 |
+
"encoder.down_blocks.2.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 151 |
+
"encoder.down_blocks.2.resnets.0.skip_conv.conv3d.weight": "0.safetensors",
|
| 152 |
+
"encoder.down_blocks.2.resnets.0.skip_conv.conv3d.bias": "0.safetensors",
|
| 153 |
+
"encoder.down_blocks.2.resnets.1.norm1.weight": "0.safetensors",
|
| 154 |
+
"encoder.down_blocks.2.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 155 |
+
"encoder.down_blocks.2.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 156 |
+
"encoder.down_blocks.2.resnets.1.norm2.weight": "0.safetensors",
|
| 157 |
+
"encoder.down_blocks.2.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 158 |
+
"encoder.down_blocks.2.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 159 |
+
"encoder.down_blocks.2.downsamplers.0.time_conv.conv3d.weight": "0.safetensors",
|
| 160 |
+
"encoder.down_blocks.2.downsamplers.0.time_conv.conv3d.bias": "0.safetensors",
|
| 161 |
+
"encoder.down_blocks.2.downsamplers.0.resample_conv.weight": "0.safetensors",
|
| 162 |
+
"encoder.down_blocks.2.downsamplers.0.resample_conv.bias": "0.safetensors",
|
| 163 |
+
"encoder.down_blocks.3.resnets.0.norm1.weight": "0.safetensors",
|
| 164 |
+
"encoder.down_blocks.3.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 165 |
+
"encoder.down_blocks.3.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 166 |
+
"encoder.down_blocks.3.resnets.0.norm2.weight": "0.safetensors",
|
| 167 |
+
"encoder.down_blocks.3.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 168 |
+
"encoder.down_blocks.3.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 169 |
+
"encoder.down_blocks.3.resnets.1.norm1.weight": "0.safetensors",
|
| 170 |
+
"encoder.down_blocks.3.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 171 |
+
"encoder.down_blocks.3.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 172 |
+
"encoder.down_blocks.3.resnets.1.norm2.weight": "0.safetensors",
|
| 173 |
+
"encoder.down_blocks.3.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 174 |
+
"encoder.down_blocks.3.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 175 |
+
"encoder.mid_block.attentions.0.norm.weight": "0.safetensors",
|
| 176 |
+
"encoder.mid_block.attentions.0.to_qkv.weight": "0.safetensors",
|
| 177 |
+
"encoder.mid_block.attentions.0.to_qkv.bias": "0.safetensors",
|
| 178 |
+
"encoder.mid_block.attentions.0.proj.weight": "0.safetensors",
|
| 179 |
+
"encoder.mid_block.attentions.0.proj.bias": "0.safetensors",
|
| 180 |
+
"encoder.mid_block.resnets.0.norm1.weight": "0.safetensors",
|
| 181 |
+
"encoder.mid_block.resnets.0.conv1.conv3d.weight": "0.safetensors",
|
| 182 |
+
"encoder.mid_block.resnets.0.conv1.conv3d.bias": "0.safetensors",
|
| 183 |
+
"encoder.mid_block.resnets.0.norm2.weight": "0.safetensors",
|
| 184 |
+
"encoder.mid_block.resnets.0.conv2.conv3d.weight": "0.safetensors",
|
| 185 |
+
"encoder.mid_block.resnets.0.conv2.conv3d.bias": "0.safetensors",
|
| 186 |
+
"encoder.mid_block.resnets.1.norm1.weight": "0.safetensors",
|
| 187 |
+
"encoder.mid_block.resnets.1.conv1.conv3d.weight": "0.safetensors",
|
| 188 |
+
"encoder.mid_block.resnets.1.conv1.conv3d.bias": "0.safetensors",
|
| 189 |
+
"encoder.mid_block.resnets.1.norm2.weight": "0.safetensors",
|
| 190 |
+
"encoder.mid_block.resnets.1.conv2.conv3d.weight": "0.safetensors",
|
| 191 |
+
"encoder.mid_block.resnets.1.conv2.conv3d.bias": "0.safetensors",
|
| 192 |
+
"encoder.norm_out.weight": "0.safetensors",
|
| 193 |
+
"encoder.conv_out.conv3d.weight": "0.safetensors",
|
| 194 |
+
"encoder.conv_out.conv3d.bias": "0.safetensors",
|
| 195 |
+
"post_quant_conv.conv3d.weight": "0.safetensors",
|
| 196 |
+
"post_quant_conv.conv3d.bias": "0.safetensors",
|
| 197 |
+
"quant_conv.conv3d.weight": "0.safetensors",
|
| 198 |
+
"quant_conv.conv3d.bias": "0.safetensors"
|
| 199 |
+
}
|
| 200 |
+
}
|